CHAPTER 07 / SECTION 01
7.1 움직임의 안정성과 구조 변화 진단하기
ADF와 KPSS를 함께 읽고 구조 변화와 분수 차분을 시점에 맞춰 적용합니다.
가격과 수익률을 따로 그린다
연구자가 지수의 10년 기록을 한 모델에 넣으려 한다. 첫해 가격 평균은 100이고 마지막 해는 300이라고 하자. 전체 평균 200은 어느 해의 평소 가격도 잘 설명하지 못한다. 반면 하루 수익률은 0% 근처를 오가되 큰 등락이 특정 기간에 몰릴 수 있다. 두 기록은 같은 시장에서 나왔지만, 앞의 문제는 수준이 이동한다는 것이고 뒤의 문제는 흔들림의 크기가 일정하지 않다는 것이다.
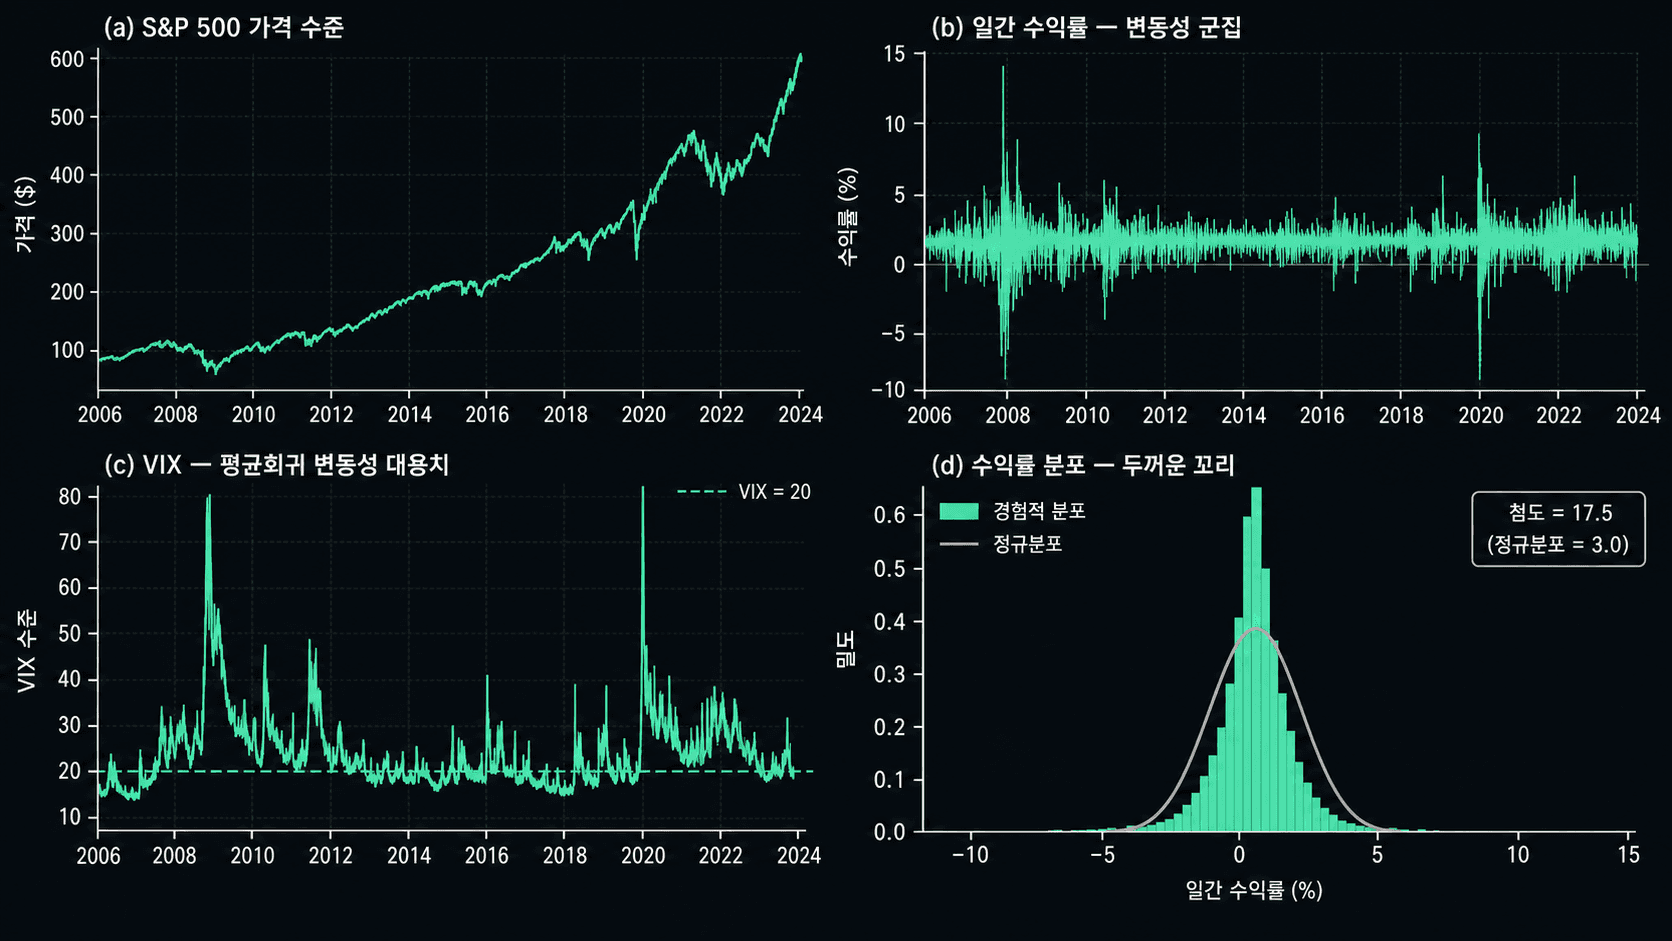
실제 지수 진단에서도 가격 수준은 장기 상승을 보이고, 일일 수익률은 중심이 더 안정적이지만 큰 등락이 몰린다. Volatility Index(변동성 지수, VIX)는 급등 뒤 평소 범위로 돌아오는 모습이 가격 수준보다 뚜렷하다. 마지막으로 일일 수익률 분포와 정규분포를 같은 축에서 보면 극단값이 정규분포보다 자주 나온다. 꼬리의 무게를 나타내는 Kurtosis(첨도)는 이 비교에서 약 17.5로, 정규분포 기준 3보다 높았다. 이 차이는 정규분포로 큰 손실의 빈도를 계산하면 과소평가할 수 있다는 단서다.
시간 순서에 어떤 의존성이 있는지도 살핀다. Autocorrelation Function(자기상관함수, ACF)은 오늘과 하루 전, 이틀 전 값의 상관을 차례로 그린다. Partial Autocorrelation Function(편자기상관함수, PACF)은 짧은 시차의 영향을 제외한 뒤 더 먼 시차가 추가 설명을 하는지 본다. Quantile–Quantile Plot(분위수 비교도, Q–Q Plot)은 관측을 크기순으로 놓고 기준 분포의 같은 순위 값과 맞춘다. 가운데는 직선에 가깝고 양쪽 끝이 멀다면 중심은 비슷해도 극단이 다르다. 이 그림들은 어떤 검정을 할지 고르는 단서다.
정상성을 두 방향에서 확인한다
Stationarity(정상성)는 평균과 분산, 시차에 따른 의존성 같은 통계적 성질이 시간에 따라 안정적이라는 뜻이다. Unit Root(단위근)가 있는 가격에서는 오늘의 충격이 미래 수준에 남을 수 있다. 반면 일정한 추세 주변에서 흔들리는 기록은 추세를 빼고 나면 안정적일 수 있다. 추세가 있는지에 대한 설정을 먼저 정하고, 비교할 두 검정에도 맞는 설정을 사용한다.
Augmented Dickey–Fuller Test(확장 디키–풀러 검정, ADF)는 단위근이 있다는 가정에서 시작한다. 그 가정 아래 지금처럼 극단적인 통계량이 드물면 기각한다. Kwiatkowski–Phillips–Schmidt–Shin Test(KPSS 정상성 검정)는 반대로 일정한 수준 또는 일정한 추세 주변에서 정상적이라는 가정에서 시작한다. P-value(유의확률)는 각 검정의 출발 가정 아래 결과가 얼마나 이례적인지 나타내며, 그 가정이 참일 확률은 아니다.
| ADF가 단위근을 기각 | KPSS가 정상성을 기각 | 함께 읽는 법 |
|---|---|---|
| 예 | 아니요 | 선택한 설정에서 정상성을 지지한다. |
| 아니요 | 예 | 비정상성을 의심한다. |
| 예 | 예 | 구조 변화, 잘못 지정한 추세, 비선형 회귀나 변동성 변화를 살핀다. |
| 아니요 | 아니요 | 판단을 보류한다. 짧은 표본이나 강한 지속성 때문에 구별하기 어려울 수 있다. |
예를 들어 매일 최근 120거래일의 가격 차이인 스프레드로 두 검정을 다시 계산한다. ADF 통계량이 0에 가까워지고 유의확률이 커지면 단위근에 반대할 근거가 약해진다. KPSS 통계량이 오르고 유의확률이 낮아지면 정상성에 반하는 증거가 커진다. 이 연속값을 다음 결정에 넣으면 한 번의 기각 여부보다 변화 방향을 더 잘 볼 수 있다. 가격 수준 외에 가치평가 비율, 변동성 대리값, 시장 움직임을 덜어 낸 수익률에도 적용할 수 있다.
서서히 떠나는 경우와 한 번에 바뀐 경우
평소 2포인트 근처였던 스프레드가 시장 제도 변경 뒤 5포인트 부근에 머문다고 하자. 전체 기간 검정에서 비정상적으로 보이더라도, 각 구간 내부는 안정적일 수 있다. 이런 평균·추세 관계의 변화가 Structural Break(구조 변화)다.
- Zivot–Andrews Test(자이벗–앤드루스 검정)는 학습창에서 후보 날짜를 비교하며 한 번의 변화를 허용해 단위근을 검사한다. 변화가 여럿이라면 한 날짜만으로 설명하기 어렵다.
- Bai–Perron Segmentation(바이–페롱 구간 분할)은 충분히 긴 기록을 여러 구간으로 나누고, 구간별 모형이 오차를 얼마나 줄이는지 비교해 여러 변화 후보를 찾는다.
- Cumulative Sum(누적합, CUSUM)은 새 관측이 기준에서 벗어난 양을 쌓아 온라인으로 감시한다. 기준이 2인데 3이 세 번 이어지면 단순 누적 편차는 1, 2, 3이다. 경보 기준이 3이라면 세 번째 관측이 들어와야 경보를 낼 수 있다. 경보 시점은 사후에 고른 최초 변화일과 다르다.
- Supervised Classification(지도 분류)은 변화 사례에 라벨이 있을 때 평균, 산포, 시차 관계, 분포 모양의 변화를 함께 입력해 변화 확률을 추정한다. 과거 라벨이 부정확하거나 새로운 유형의 변화가 오면 확률도 신뢰하기 어렵다.
확인한 변화 이후 경과 일수, 전후 평균, 누적합과 변화 확률은 각각 특성이 될 수 있다. 이전 날짜로 경보를 소급해 채우거나, 변화 이후 자료가 아직 쌓이지 않았는데 이후 평균을 미리 붙이면 정보가 샌다.
얼마나 차분할지 학습 구간에서 정한다
가격 100, 102, 105포인트의 First Differencing(1차 차분)은 전날 수준을 빼서 2, 3포인트를 남긴다. 추세는 약해지지만 오래 쌓인 가격 정보도 많이 사라진다. Fractional Differencing(분수 차분)은 0차인 원래 수준과 1차 차분 사이에서, 더 오래된 값에도 점점 작은 가중치를 주는 방법이다.
- Lagged Observation(시차 관측값)
- 거래일 전 가격(포인트)
- Fractionally Differenced Value(분수 차분값)
- 결정일의 변환 가격(포인트)
- Time Index(결정일 번호)
- 거래일 기준
- Lag(시차)
- 거래일
- Maximum Lag(최대 시차)
- 거래일
- Differencing Order(차분 차수)
- 단위 없음
- Lag Weights(현재 및 과거 관측 가중치)
- 단위 없음
차수가 0.5라면 첫 세 가중치는 1, −0.5, −0.125다. 두 시차까지만 남긴 계산에서는 마지막 날 값이 다음과 같다.
이 값은 수익률이 아니다. 실제로는 가중치가 충분히 작아질 때까지 또는 최대 길이까지 과거를 보며, 설정에 따라 값과 준비 기간이 달라진다. 완전한 길이가 모일 때까지 결측으로 두고 Validity Mask(유효성 표시)를 남기면 모든 유효 행에 같은 필터가 적용된다. 앞부분에 있는 값만 사용하면 행은 늘지만 초기 행의 필터는 짧다. 두 방식을 같은 특성처럼 섞지 않는다.
Autoregressive Fractionally Integrated Moving Average(자기회귀 분수적분 이동평균, ARFIMA)의 정상적 장기기억 모형에서는 보통 에서 자기상관이 짧은 기억 모형보다 천천히 줄어든다. 이론적 조건이 개별 가격 변환의 정상성을 보장하지는 않는다. 학습 구간에서 차수 후보마다 ADF와 원래 수준과의 상관, 유효 행 수를 비교하고, 진단 기준을 만족하는 작은 차수를 고른다. 높은 원계열 상관은 정보가 많이 남았다는 단서일 뿐 예측력을 증명하지 않는다. 선택한 차수와 절단 규칙을 고정해 다음 구간에 적용한다.